
立即联系我们
 提交成功!
 提交失败!

本月 16 日,在华泰证券创新科技论坛上,「DaoCloud 道客」的创始人&首席执行官、 云原生计算基金会全球大使 -陈齐彦,就大语言模型蓬勃发展背后的逻辑,从云原生视角进行了详细解读和分享。
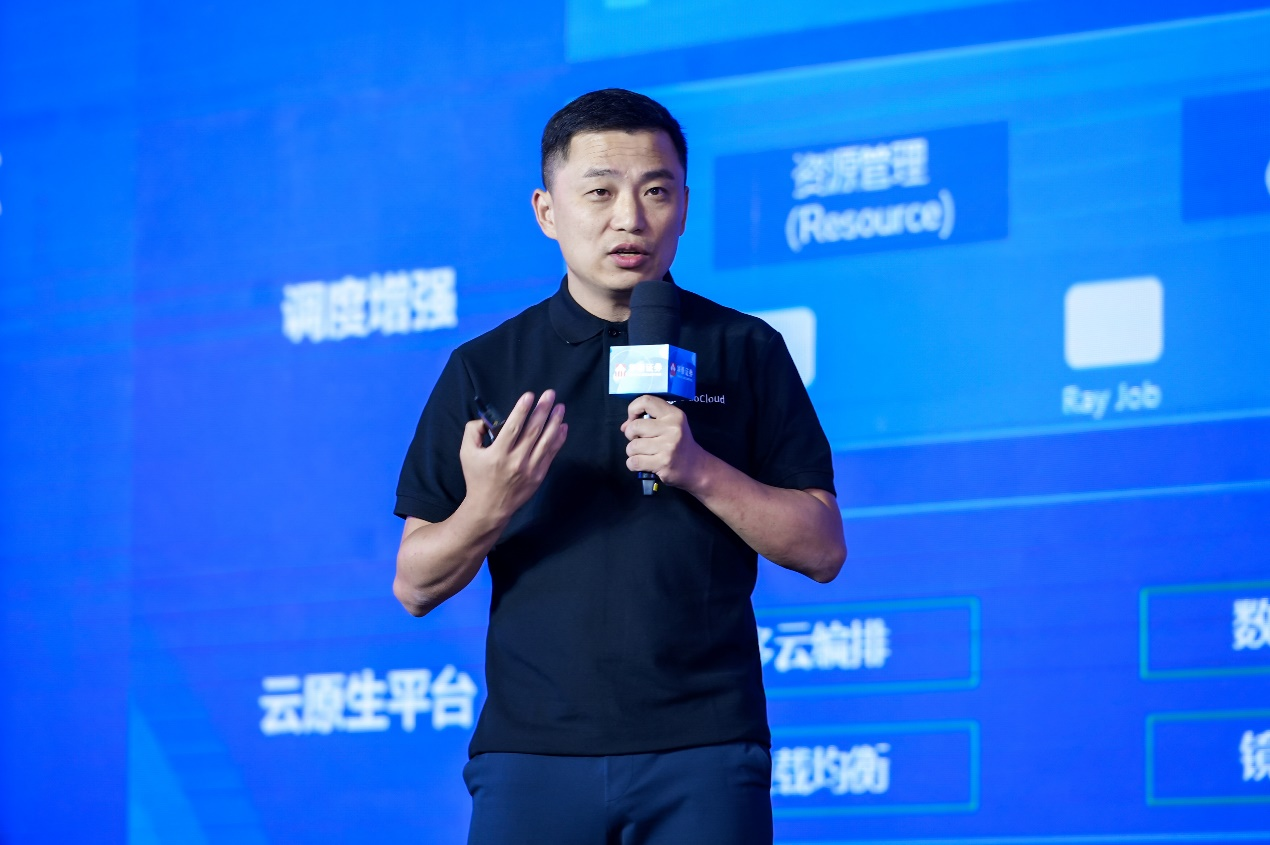
AGI 的创新方向和数字原生的终极愿景是高度一致的,数据作为核心生产力的要素,我们发现需要在机器和数据之间建立新的 IT 架构,如今 ChatGPT 的出现,让我们在聊天中感觉到它努力伪装成人类,其实这是硅基智能学会进入碳基智能世界的方式,这也是大模型的一种交互形式。
随着 Open AI 的发展,大家意识到了一些数字化生产关系的变化,数据与机器之间生产力关系的搭建,是企业通往未来的数字化人工智能的必备条件。因此大家努力要将大模型的技术应用到企业自身的发展中,然而在通往大模型的技术路径上,会遇到很多问题。
例如:
1、超大模型它的计算的复杂度非常高,这也意味着对硬件的消耗、资源的消耗就会非常庞大,如何满足硬件和资源的需求?
2、在计算过程中,我们面临的不仅仅是一个单一的计算模型,可能是一个异构计算的模型,可能得到的是有限的 AI 算力,所以我们不得不在有些场景里去找 AI 算力的备选方案。因此,异构算力兼容也是一个困难。
3、其实 Open AI 里面有大量的软件技术和硬件技术,它们相互叠加,那么其中最重要的问题是解决资源分配和任务调度,以及快速地使人跟机器在做训练的过程当中,哪怕是无监督的训练的过程当中,也能自主完成指令,降低开发成本。
4、同时,隐私安全、数据风险和监管合规等等安全问题,也十分重要。
那么面对上述的问题,新技术的风起云涌,产业界如何破局呢?今天我们对很多新技术的探知和了解,其实是有底层逻辑,新技术是有供应链的,最终的源头都在开源世界里。
举个例子来说,在去年疫情期间,我们公司的技术团队在维护 Kubernetes 上游代码的时候,遇到一个团队做 Ray 这个开源项目,跟我们交流了很多关于大数据架构的语言深化、传统的 AI 训练模型等问题。当时我们无法理解这些需求背后的场景是什么,但是在前几个月参加欧洲举行的 KubeCon 大会时,我们发现 Ray 背后的公司 Anyscale 已经变成了一个现象级的网红公司。这才意识到原来给我们提的这些探讨,其实是因为在帮 Open AI 做一个基础设施平台,这个基础设施平台有大量的关于计算和调度的需求,运用到了我们在维护的 Kubernetes 模块,最终配合 Ray 蜕变成一个高性能的分布式执行引擎,可以在一个相当有限的计算环境里面开发一个充分利用分布式能力的开发框架。然后因为 Open AI的爆火,导致 Ray 也备受追捧。Ray 可以说是 Open AI 成功路上一个不可或缺的组成部分。
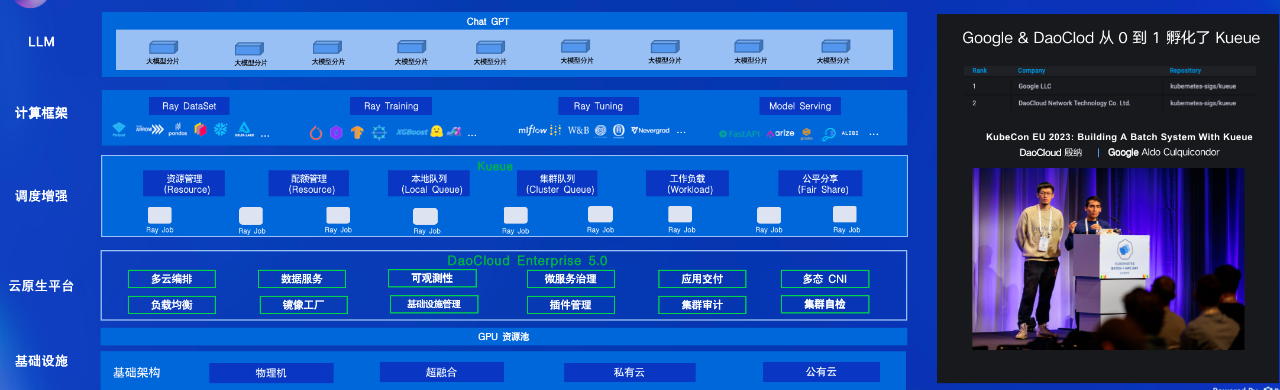 LLM + Ray + Kueue + DCE 5.0 = 增强型算力平台,帮助用户构建自有大语言模型
此外,我们在做进一步技术研发的过程中,跟 Google 一起发现了对于计算调度增强方面的需求,于是双方携手开源了 Kueue 这个项目,在看 Open AI 的底层架构时,我们发现它也是非常重要的能力模块。
当然上面的这些例子还可以让大家看到一个现象,那就是有很多创新的技术在大模型还没有成功的时候,可能只是一些零碎的局部创新,使用场景并不明确;但当大模型成功的时候,会发现这些技术正是大模型爆发成功的一环,这些技术的创新演进与大模型的发展是相辅相成的。
同时在通往大模型的道路上有很多新的技术路径,除了暴力美学的大语言模型外,还有一些微调大模型和开源模型的选择,暴力美学模型用极致的算力和参数,试图让硅基智能拥有无所不知的语言能力,但实际上每个被推出的大语言模型都有自己的独特性和局限性。在不断理解大模型的架构和底层基础设施能力后,也许可以找到更适合自己的、通往大模型的一条可行路径。作为一家做 to B的企业,拥有边界感的语言模型会更符合实际使用场景的创新需求。
那么如何驾驭好大模型的能力同时,也跟自己企业的私有化架构结合呢?
随着 Meta 把 LLaMa 开源出来,对于大模型的微调,产业界做了很多尝试和创新,基于大模型,只是用非常有限的算力,非常低的成本投入,就能训练出专属化的大语言模型,这个在技术、工程和效率上都找到非常好的平衡点,“羊驼家族” 因此迎来了大爆发发展。
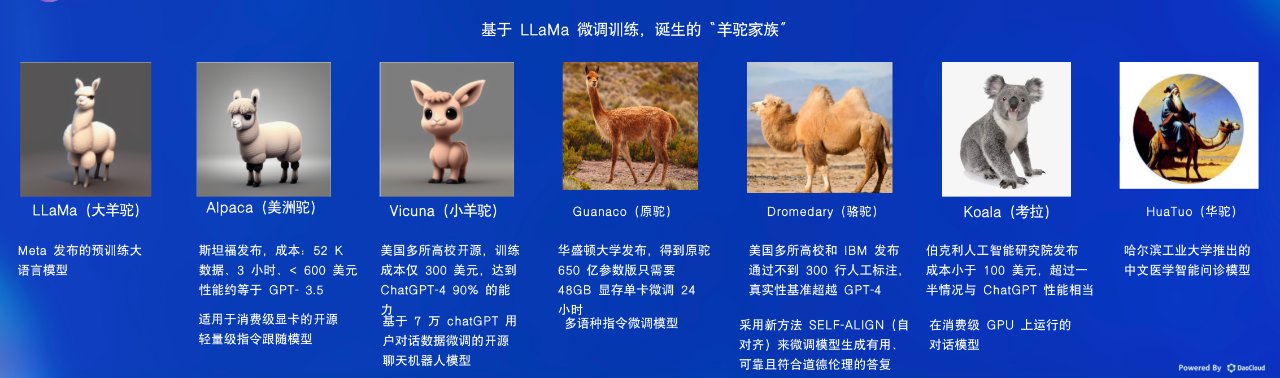 基于预训练大语言模型微调,获取性能匹敌 ChatGPT 的专属化 “平替” 模型
其次,不得不提 LangChain,专业化的大语言模型变成生产力要和企业自己的知识库相结合,原来知识库存在数据库里,现在要把知识库向量化,通过 LangChain 调用大模型,打造自己的专业化聊天模型。这条路径是更容易实现的,既符合 LLM 给我们带来的技术创新,又符合大量的专业化应用场景和驾驭好大模型的能力,是比较适配 To B 企业场景化应用的。
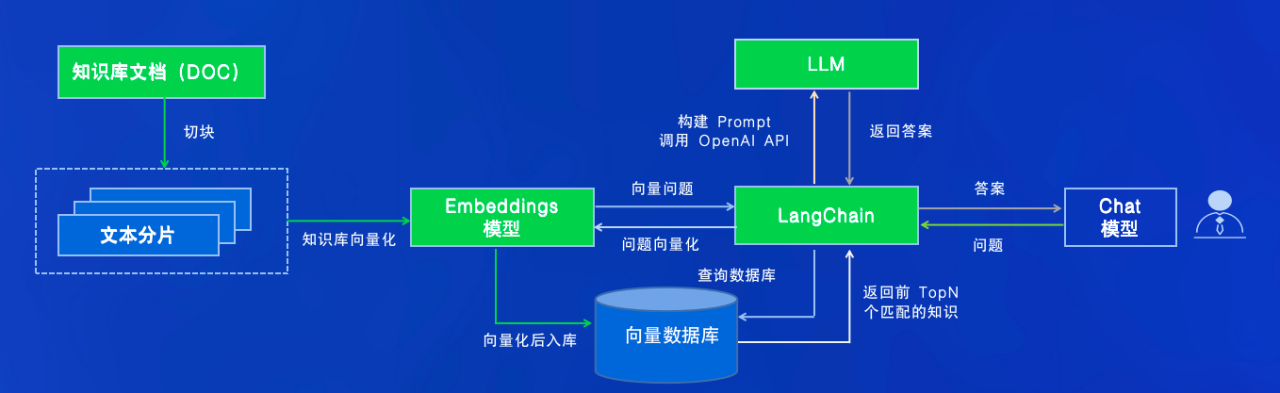 LangChain + LLM + Doc = 构筑企业专属知识库,增强客户交互体验
在训练大模型过程中,数据是大模型的原材料,针对具体场景,数据的覆盖和质量至关重要。训练模型时,需要关注敏感数据的保护和安全合规,并有效管理大量的数据和标签,不断进行测试和模型的迭代,不断提升 LLM 模型的专业化,当精准度的阈值可以到达 99% 以上的时候,就可以将企业场景与大模型融合应用,实现大模型向企业生产力的转型。
尤其是金融行业,不允许出现 90% 精确度的场景,因为这不合规,而且不合规产生的风险往往带来的负面影响比较大的,所以我们必须要把专业度的东西提高上去,再结合专业的私有化或者专业属性的 LLM 就能够让精确度提升到 98-99%,这才是安全边界下的大语言模型和企业应用场景的结合。
「DaoCloud 道客」也身体力行的在这个大模型的世界中摸索前行,我们尝试了三件事。
首先,因为我们做基础软件,很难轻易信任 Open AI 给到的程序代码,因此「DaoCloud 道客」跟 HI Bug一起通过与大模型的结合,完成私有化部署研发代码的审计和 AI 编码工具,帮助企业加速开发流程、帮助程序员提高代码质量、降低开发成本提升效率。
同时,作为一个提供专业化产品的公司,我们除了将产品提供给客户,还会为客户提供很多培训,与此同时除了专业的企业客户,我们还在服务大量的开发者,会发现沟通成本不断提高,基础的问题也会占用技术人员很多的时间。于是我们把过去总结下来的大量的产品操作的文档都投喂给了 LangChain 的模型,实现了一个非常专业的产品使用助手,可以帮助大家用最低的成本来学习我们企业的产品,更便捷的操作,基础的问题解答也不需要麻烦我们的技术人员,一定程度上解放了我们自己的生产力。
此外,我们在运维工作中会收集到大量的机器数据,包含机器 API 的调用和日志等,我们把这些数据都投到大模型上,让大模型学会自我诊断,可以通过互动的方式让系统去筛查机器的问题,并找出对应的特征和现象,甚至可以通过系统实现对机器的操作与及时反馈诊断修复。
综上所述,我们会发现,在一个现象级的应用产生的背后会有很多问题需求,需要去解决很多基础设施的能力,包含系统在高速连接情况下的弹性及高可用,算力基础设施和应用需求之间的调度,以及在跨域、跨网络、跨集群和跨云情况下的计算分布问题等等,这些能力都在云原生的世界里完成了。而这其实不是云原生为了 Open AI 做了那么多,而是 Open AI找到了可以支撑它崛起的基础设施能力。
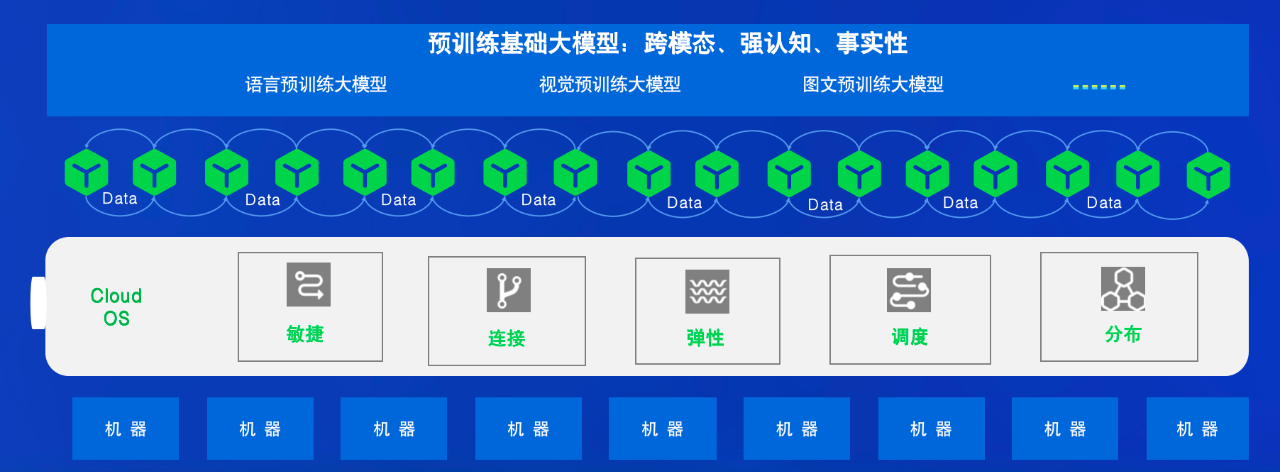 云原生为实现 AIGC 产业落地奠定坚实基础
因此,对于很多技术的发展方向并不是一早就设计好的,每个人在自己擅长的赛道里解决各自的问题,只要技术符合发展趋势,我们都会成为未来问题中的一个最优解。在数字科技时代的浪潮下,只有更开放的心态,拥抱更多开放的技术、更宏观的视野,才能将自己未来的路走得更宽阔繁荣。
对于 OpenAI 的崛起,我个人对未来大模型、AGI 在开源路径上的繁荣抱有极大的乐观,要知道我们在云原生、开源技术背后,拥有着一种庞大的生产力关系。根据 Linux Foundation 疫情期间的统计数据,围绕基础软件开发的开源贡献,相当于 260 亿美金的生产力价值,这是全世界软件工程师团结在一起,为人类社会在某种程度上的科技进步做着默默无闻的奉献。
在这样庞大的生产力加持下,未来在云原生开源世界里将会诞生出更多新兴技术,在这里希望大家持续关注云原生技术,更要去关注云原生技术背后的庞大开源技术生态,这样你将看到更多、更有意思的基础性能力在这里成长出来。然后我们才可以骄傲地说,云原生帮助企业不仅是解决数字基础设施问题,也是今天迈向通用人工智能关键的一步。
最后,在找到正确方向的路上,送大家一句互勉的话:但行好事,莫问前程。
希望大家都可以找到正确,并为之持续努力奋斗的路径。
 沪公网安备31011002001590| 上海市杨浦区江湾城路 99 号 6 号楼 7F


